Como criar skills para agentes de IA, do zero
O que é uma skill, como crio as minhas, quando ela vira script e a escada do prompt à orquestração, com o que as fontes corrigem.
Já faz um tempo que escrevo skills para o Claude Code. E uso o /superpowers:writing-skills para isso.
Antes de escrever este texto, fui ler a documentação oficial com calma. Boa parte confirmou o que eu já fazia. Uma parte, não. E tem um ponto em que as próprias fontes oficiais discordam entre si.
A ideia é cobrir seis coisas:
- O que é uma skill, explicado do zero.
- A minha tese: skill é repetição documentada, e às vezes dali sai um script.
- Uma escada que imagino, do prompt à orquestração de agentes, e o que as fontes corrigem nela.
- Como eu crio, com o
writing-skills. - O gatilho (a
description) e o ponto em que as fontes divergem. - Um caso meu, a
melhoria-continua, separando o que existe do que é só plano.
Bora.
O que é uma skill
Uma skill é uma pasta com um arquivo chamado SKILL.md. O arquivo tem um cabeçalho (o frontmatter), escrito em YAML, um formato de texto simples de chave: valor. Nele ficam o name e a description. Depois vêm as instruções em Markdown. Ao lado, pode haver scripts e arquivos de referência.
Um cabeçalho completo, só para dar noção. É a skill do passo a passo, mais abaixo, com o allowed-tools, que acrescentei. O resto é traduzido e adaptado do exemplo summarize-changes da documentação do Claude Code, e o passo a passo diz o que mudei:
---name: resumindo-mudancas # obrigatório no padrão aberto; igual ao nome da pastadescription: >- # obrigatório no padrão aberto; diz quando usar a skill Use quando o usuário perguntar o que mudou, pedir mensagem de commit ou revisão do diff local.allowed-tools: Bash(git diff *) Bash(git status *) # opcional; libera esses comandos sem pedir permissão---É só um exemplo. No padrão aberto, name e description são os únicos campos obrigatórios. O Claude Code é mais flexível: assume o nome da pasta quando falta o name e trata a description como recomendada.
O allowed-tools é opcional, e o padrão o marca como experimental. As instruções vêm depois do segundo ---, em Markdown. A lista completa de campos está na documentação do Claude Code.
A Anthropic compara com um guia de integração para quem acabou de entrar no time. É uma boa imagem. Você não repete a explicação toda vez. Entrega o guia, e a pessoa consulta quando precisa.
O agente trabalha dentro de um contexto: o texto que ele tem à vista na conversa, e que tem limite de tamanho. A skill entra nele aos poucos:
- No começo da sessão, ele vê só o nome e a descrição de cada skill. Isso custa algo em torno de 100 tokens por skill. Token é a unidade em que o modelo conta texto: grosso modo, pedaços de palavras.
- Quando a sua tarefa casa com a descrição, ele lê o corpo do
SKILL.md. - Se o corpo mandar, ele abre outros arquivos ou roda scripts. Do script, só a saída entra no contexto.
Você também pode chamar a skill na mão, escrevendo /nome-da-skill no começo da mensagem.
Um prompt avulso vale para uma conversa. A skill carrega sob demanda, em qualquer conversa, sem você colar o mesmo texto de novo.
Já o CLAUDE.md é o arquivo de instruções do projeto, e o Claude Code o lê inteiro no começo de toda sessão. A documentação do Claude Code sugere mantê-lo abaixo de 200 linhas e mover para skills o que virou procedimento em vez de fato.
Existe ainda uma terceira via, que volto a citar mais abaixo: o hook (documentação). É um comando que o Claude Code roda sempre que um evento acontece, como antes de editar um arquivo. Serve para a regra que precisa valer sempre, quer o agente lembre dela ou não.
O formato é um padrão aberto, desenvolvido originalmente pela Anthropic e com especificação pública. O Claude Code segue o padrão e acrescenta extensões próprias.
Skill nasce de repetição
A minha tese cabe numa frase: skill é algo que eu faço de forma repetitiva e documento.
Não precisei inventar o gatilho. A documentação do Claude Code diz, em tradução livre, que vale criar uma skill quando você fica colando no chat as mesmas instruções, o mesmo checklist ou o mesmo procedimento de vários passos. A visão geral da mesma documentação coloca a régua na terceira vez.
Então o passo zero é um teste simples. Se você nunca colou aquele procedimento no chat, ainda não precisa de skill.
E como começar? O guia do padrão aberto recomenda partir de uma tarefa real. Faça o trabalho com o agente, corrija o que ele errar e só depois extraia o padrão. Pedir a uma IA que invente a skill só com o conhecimento geral dela rende instruções vagas, como mandar tratar os erros de forma apropriada.
Skill boa carrega o que é seu: o formato que você usa, os atalhos do seu projeto, as correções que você já fez.
E aqui entra a segunda metade da tese. Às vezes, dali sai um script em vez de prosa.
Prosa ou script?
Escrevi sobre isso em Determinismo vira script. O teste que eu uso é este:
Se duas execuções corretas do mesmo passo produzem a mesma saída, é script. Se podem produzir saídas legitimamente diferentes, é inferência.
Contar quantos arquivos existem numa pasta: mesma entrada, mesma saída. Script. Decidir se um rascunho está claro para quem vai ler: cada leitura pode pesar diferente. Prosa.
Esse critério é meu. Nenhuma fonte oficial que li o formula assim. Mas ele conversa com duas ideias que estão lá:
- Graus de liberdade. O guia de boas práticas da plataforma Claude fala em adequar a rigidez à fragilidade da tarefa. A imagem é a de uma ponte estreita, com um único caminho seguro (instruções exatas), contra um campo aberto, com vários caminhos (direção geral).
- Sinal de repetição. O guia de boas práticas do padrão aberto diz que, se o agente reinventa a mesma lógica a cada execução, isso é um sinal para escrever um script testado e empacotá-lo na skill.
O guia da plataforma tem uma frase direta: prefira scripts para operações determinísticas. E o post de engenharia da Anthropic sobre skills diz que muitas aplicações exigem uma confiabilidade determinística que só código dá.
Repare no tom, porém. O texto oficial é condicional: pesa confiabilidade, custo de contexto e repetição observada. Nenhuma fonte manda fazer script sempre que o passo for determinístico. Essa radicalização é minha.
Na prática, é assim que eu separo:
| Se o passo… | Vira | Por quê |
|---|---|---|
| dá sempre a mesma saída para a mesma entrada | script, dentro da skill | o agente chama, em vez de refazer |
| depende de contexto e pode variar com razão | prosa na skill | julgamento não cabe em código |
| precisa valer toda vez, sem depender de o agente lembrar | hook | o Claude Code roda o hook sempre que o evento ocorre |
A documentação do Claude Code é explícita no terceiro caso: se o Claude pulou uma regra que precisa valer sempre, mova a regra para um hook.
Script também tem custo. A checklist de segurança da própria Anthropic trata script em skill como risco alto, porque ele roda com acesso ao ambiente. E escrever script para agente tem manha. O guia de scripts do padrão aberto trata disso: sem pergunta interativa, com --help claro, saída estruturada e erro que diz o que fazer.
Sobre por que lembrar não basta, escrevi também em Gotcha lembrado é gotcha esquecido.
Da repetição à orquestração
Tenho uma intuição de como as tarefas crescem. Fui conferir se as fontes concordam com ela.
A ideia
Imagino uma escada em que cada degrau custa mais que o anterior:
- Você percebe que repete o mesmo prompt, o pedido que digita para o agente.
- O prompt vira uma skill.
- A skill ganha um script para o passo que nunca muda. Ela continua existindo e sabe executá-lo.
- A tarefa vira um subagente: um assistente que o agente principal chama. Ele trabalha numa conversa própria, com contexto próprio, e devolve só um resumo.
- Vários agentes viram orquestração: algo decide quais rodam, em que ordem e com que parte do trabalho.
Adianto o veredito. A escada funciona como heurística de custo crescente: comece pelo mais barato e suba quando aparecer um gatilho. Como lei, que toda tarefa percorreria em ordem, as fontes não a confirmam.
O que as fontes confirmam
- Prompt vira skill por repetição. Já vimos isso em “Skill nasce de repetição”, com a régua da terceira vez. A visão geral acrescenta o caso do pedido curto: quem digita sempre o mesmo prompt para começar uma tarefa pode salvá-lo como skill e chamá-lo pelo nome.
- Skill ganha script para o passo determinístico. É a frase do guia da plataforma que citei em “Prosa ou script?”.
- A skill continua e diz como usar o script. A seção Provide utility scripts do guia da plataforma pede que fique claro se o Claude deve executar o script ou ler o arquivo como referência. O exemplo dela usa um script que extrai os campos de um formulário em PDF. Numa instrução, o Claude o roda e usa o resultado. Na outra, só lê o código para entender a lógica. Ao executar, só a saída entra no contexto.
- Comece pelo simples. O texto Building effective agents recomenda achar a solução mais simples possível e só aumentar a complexidade quando necessário. Isso pode significar nem construir um sistema de agentes.
- Subir tem custo medido. Falo dos números mais abaixo.
O que as fontes corrigem
São sete correções, e cada uma muda o desenho da escada.
- O script mora dentro da skill. Os graus de liberdade vistos acima pedem texto livre quando há vários caminhos e “rode exatamente este script” quando só um é seguro. Para mim, isso é uma posição dentro da skill, e a fonte não a chama de etapa de maturidade.
- O subagente resolve outro problema. A documentação dos subagentes lista cinco motivos, e entre eles estão preservar o contexto, impor restrições (limitar as ferramentas) e controlar custo (usar um modelo mais barato). A página do SDK destaca também o paralelismo. O gatilho da visão geral, em tradução livre, é “uma tarefa lateral enche a conversa de saída que você não vai reler”. Nas páginas que li, o gatilho nunca é “a repetição cresceu”.
- Skill e subagente se combinam. Uma skill com
context: forkroda dentro de um subagente. Um subagente com o camposkillsjá nasce com skills carregadas. A documentação descreve uma forma como a inversa da outra. - A orquestração pode morar dentro de uma skill. A visão geral traz o padrão “skill + subagente”, em que a skill chama subagentes para o trabalho paralelo. O
/batché uma skill que divide uma mudança grande em 5 a 30 subagentes, cada um numa cópia isolada dos arquivos. A página sobre trabalho em paralelo o descreve como um uso empacotado de subagentes, sem um estilo de coordenação à parte. - No topo, a orquestração volta a ser script. Um workflow dinâmico é um script em JavaScript que orquestra muitos subagentes. A documentação diz, em tradução livre, que ele “move o plano para o código”. Com subagentes e skills, quem decide o que roda a seguir é o Claude, a cada turno. No workflow, quem decide é o script.
- A escada tem ramos. A tabela “Build your setup over time” da visão geral segue uma ordem aproximada, segundo a própria página. Nela o subagente vem antes do hook, e o script nem aparece. Entram ainda o MCP, que conecta o agente a um serviço externo, e o plugin, um pacote que reúne skills, hooks, subagentes e MCP. E os comandos customizados foram fundidos nas skills.
- Falta o caminho de volta. O texto Harness design for long-running application development afirma, em tradução livre, que cada componente de um harness (a estrutura de código e prompts em volta do modelo) embute uma suposição sobre o que o modelo não faz sozinho. E que essas suposições vão envelhecendo. O autor do texto removeu uma etapa quando o modelo melhorou. No mesmo texto, o harness completo custou mais de 20 vezes mais, e a diferença de qualidade foi evidente. Subir pode valer. Descer também.
O círculo e os três determinismos
O item 5 me fez notar um círculo. A escada começa numa regra minha: o que dá sempre a mesma saída vira script. E termina num workflow, que é um script de novo, só que com o determinismo em outro lugar.
Separo três sentidos dele, e tanto o círculo quanto essa separação são leitura minha:
- Da saída. Um script dá o mesmo resultado para a mesma entrada.
- Do disparo. O hook sempre roda quando o evento acontece. A skill, que depende da interpretação do Claude, pode variar.
- Do fluxo de controle. No workflow, o script fixa a ordem do que roda. O que cada agente responde continua vindo de um modelo.
O diagrama
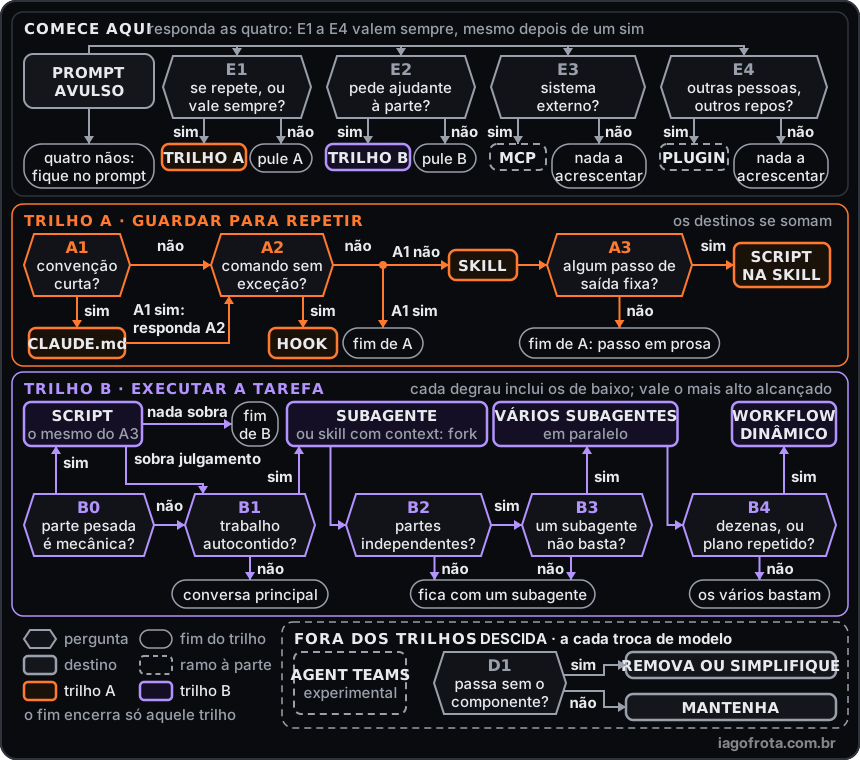
O diagrama desenha o fluxo de decisão, que vem logo depois da tabela. As letras da figura são as perguntas listadas lá: E de entrada, A do trilho de persistência, B do trilho de execução e D da descida. A figura é em paisagem e se lê da esquerda para a direita; no celular, ela rola para o lado dentro do próprio quadro. Os hexágonos são as perguntas, as caixas cheias são os destinos, as pílulas marcam o fim de um trilho, e só daquele trilho, e as caixas tracejadas são ramos à parte. Cada seta que sai de uma pergunta diz sim ou não. Na faixa de cima, marcada com comece aqui, o prompt avulso leva às quatro perguntas de entrada, cada uma com o seu sim e o seu não: E1 leva ao trilho A, E2 ao trilho B, E3 ao MCP e E4 ao plugin. No trilho A, de guardar para repetir, em laranja, o CLAUDE.md e o hook ficam abaixo das perguntas A1 e A2, e a skill é o que sobra quando as duas dão não. O trilho B, de executar a tarefa, em violeta, abre com uma pergunta sobre trabalho mecânico, que leva a um script, e depois sobe uma escada de subagente, vários subagentes e workflow dinâmico, desenhada acima das perguntas. Na faixa de baixo, fora dos trilhos, ficam os agent teams, soltos, e a descida.
A tabela
Para o iniciante, enxuguei a tabela, e cada linha traz o gatilho que justifica subir, o que você ganha, o que paga e uma fonte pública. A ordem é de custo crescente, com os ramos no meio. Essa ordenação é leitura minha.
| Degrau | Gatilho para subir | O que ganha | O que custa | Fonte |
|---|---|---|---|---|
| Prompt avulso | Ponto de partida | Nada para manter | Reescrever a instrução toda vez | Building effective agents |
| CLAUDE.md | O agente erra a mesma convenção duas vezes, ou a regra precisa valer desde a primeira conversa | Contexto sempre presente | Carrega em toda sessão; manter abaixo de 200 linhas | Visão geral |
| Skill (prosa) | Colar o mesmo pedido ou procedimento pela terceira vez | Procedimento sob demanda | A descrição ocupa o catálogo; o resultado pode variar | Skills |
| Skill com script | O agente reinventa a mesma lógica a cada execução | Saída repetível; só a saída entra no contexto | O script roda com acesso ao ambiente, risco alto na checklist de segurança | Boas práticas |
| Hook (ramo) | Algo precisa acontecer toda vez, sem depender do agente | Disparo garantido | Um hook de comando não raciocina; para julgamento, a documentação prevê hooks de prompt ou de agente | Visão geral, hooks |
| MCP (ramo) | Dado ou ação em sistema externo | Conexão pronta | Os nomes das ferramentas ficam no contexto | Visão geral |
| Subagente | Tarefa lateral enche a conversa; ferramentas ou modelo limitados | Contexto principal limpo | Tokens próprios; não vê o histórico; só o resumo volta | Subagentes |
| Vários subagentes | Partes independentes, e um subagente só não dá conta (a conversa encheria ou ficaria lenta demais) | Paralelismo | Multiplicador de tokens; resultados voltam ao contexto | Pesquisa multiagente |
| Workflow dinâmico | Dezenas de partes, ou o plano precisa ser repetível | Plano em código; só a resposta final volta | Muitos agentes e tokens; recurso recente | Workflows |
| Agent teams (ramo) | Pares precisam conversar e dividir uma lista de tarefas | Colaboração entre sessões | Experimental; bem mais tokens | Agent teams |
| Plugin | Outras pessoas precisam da mesma configuração em outros repositórios (só para você, a pasta pessoal basta; para o time no mesmo repositório, o commit basta) | Skills, hooks, subagentes e MCP juntos (regras só entram escritas como skill) | Manter o pacote | Visão geral, plugins, componentes |
| Descida | O modelo passa sem o componente | Menos custo, menos coisa para quebrar | Perde o ganho se o modelo ou a tarefa mudar | Harness design |
O fluxo de decisão
Escrevi o fluxo em perguntas de sim ou não. Cada pergunta tem uma fonte, mas a montagem é leitura minha. O teste “mesma entrada, mesma saída” já foi dito antes e também é meu.
Para ler o fluxo, responda em ordem e anote um destino a cada sim. As quatro perguntas de entrada valem sempre, mesmo que uma delas já tenha dado sim. Dentro de um trilho, o texto diz qual pergunta vem depois, e “fim do trilho” quer dizer que você para ali. No trilho A, os destinos se somam. No trilho B, cada degrau já inclui os de baixo, e vale o mais alto que o seu percurso alcançou. O script (do A3 ou do B0) e um degrau do trilho B também se somam: o script faz a parte mecânica, e o subagente, os vários subagentes ou o workflow ficam com o que exige julgamento.
Entrada. Responda as quatro perguntas.
- E1. Isso se repete entre conversas, ou é uma regra que precisa valer em toda conversa? Você já colou o mesmo procedimento pela terceira vez, o agente já errou a mesma convenção duas vezes, ou a regra tem de valer desde a primeira conversa? Sim: percorra o trilho A. Não: pule o A.
- E2. A tarefa de agora pede um ajudante à parte? Pode ser muita saída que você não vai reler, a necessidade de ferramentas ou modelo limitados, partes que parecem poder andar sozinhas ou uma parte pesada e mecânica, como mexer em centenas de arquivos. Sim: percorra o trilho B. Não: pule o B.
- E3. A tarefa precisa de um dado ou de uma ação em um sistema que o agente não alcança sozinho? Uma aba do navegador, um banco de dados, o Slack. Sim: MCP. Se existir uma skill, ela ensina a usá-lo. Não: nada a acrescentar.
- E4. Outras pessoas precisam receber a configuração que você montou (skills, hooks, subagentes ou MCP) em outros repositórios, e não só naquele em que você a usa hoje? As duas condições valem ao mesmo tempo: são outras pessoas e são outros repositórios. Sim: plugin. Ele carrega skills, hooks, subagentes e MCP. Regras do
CLAUDE.mdou de.claude/rules/não vão como estão: a documentação dos componentes diz, em tradução livre, que instruções entram num plugin escritas como skill, e que oCLAUDE.mdna raiz do plugin não é carregado. Se a regra precisa valer toda vez, a mesma página manda usar um hook. Não, porque falta uma das duas condições: nada a acrescentar, o que você já tem resolve. Só você, mesmo em vários repositórios seus, usa a pasta pessoal:~/.claude/skills/para skills,~/.claude/CLAUDE.mde~/.claude/rules/para regras,~/.claude/settings.jsonpara hooks. Só o time, no mesmo repositório, usa o que você commita:.claude/skills/,CLAUDE.mde.claude/rules/,.claude/settings.json. - Quatro respostas “não”: fique no prompt.
Sobre o E4, as fontes divergem um pouco. A visão geral lista, em tradução livre, “um segundo repositório precisa do mesmo setup” como gatilho do plugin. A página de plugins lembra que skills, hooks e MCP funcionam sozinhos, e que uma skill em ~/.claude/skills/ já vale em todos os projetos da sua máquina. Ela traz ainda uma terceira posição, em tradução livre: faça um plugin “para dar a sua configuração aos colegas de time”, instalá-lo em vários projetos ou publicar versões, o que, sozinho, não separa colega do mesmo repositório de colega de outro. Na minha leitura, o time no mesmo repositório fica com o commit, e a página de skills (“commite para o seu time receber também”, em tradução livre) e a de configurações (commitar o .claude/settings.json) sustentam essa escolha. O time com vários repositórios, o caso do E4, vai para o plugin.
Por isso a pergunta separa quem recebe: só você, o time do repositório ou outras pessoas em outros repositórios. Os caminhos de regras, hooks e skills vêm da documentação de memória, das configurações e da página de skills.
Trilho A: persistência.
- A1. O que você quer guardar é uma convenção curta que o agente precisa saber em toda sessão, como “use pnpm” ou “os testes ficam em /tests”, e não um procedimento nem um comando para ele rodar? Sim: CLAUDE.md, e siga para A2. Não: A2.
- A2. Em um momento exato (antes de editar um arquivo, ao commitar, ao terminar uma resposta), um comando tem de rodar ou uma ação tem de ser barrada, sem exceção, mesmo que o agente esqueça? Sim: hook, e é o fim do trilho. Na figura, é a seta rotulada “A1 sim: responda A2”: uma convenção que também não pode falhar, como “nunca edite o .env”, fica nos dois, com a linha no CLAUDE.md para o agente saber e o hook para garantir. Não: se A1 deu sim, é o fim do trilho; se A1 também deu não, o que você quer guardar é uma skill, e a próxima é A3.
- A3. Algum passo dá sempre a mesma saída para a mesma entrada, ou o agente reescreve a mesma lógica a cada vez? Sim: script dentro da skill. Diga na skill se o agente o executa ou o lê. Não: o passo fica em prosa. Fim do trilho. A skill pode ter uma linha só: um pedido curto que você sempre digita vira skill, chamada pelo nome, porque a documentação fundiu os comandos salvos nas skills.
Trilho B: execução.
Orquestração é o que eu ainda estou estudando e praticando, então não vou me aprofundar nela aqui.
- B0. A parte pesada é mecânica, ou seja, a mesma entrada dá sempre a mesma saída, como renomear uma variável em centenas de arquivos ou conferir um cabeçalho de licença? Sim: script, o mesmo do A3 (se a tarefa vai se repetir, ele mora numa skill). Se sobra uma parte que exige julgamento, a próxima é B1, só para essa parte. Se não sobra nada, é o fim do trilho. Não: B1.
- B1. O trabalho é autocontido: dá para entregar o pedido e receber o resultado, um resumo ou os arquivos prontos, num lugar combinado, sem vai e vem com você no meio? Sim: subagente, ou uma skill com
context: fork, e a próxima é B2. Não: fim do trilho, fique na conversa principal. - B2. O trabalho se divide em partes independentes, que não dependem do resultado umas das outras nem mexem nos mesmos arquivos? Sim: B3. Não: fim do trilho, fique com um subagente só, sem paralelizar.
- B3. Um subagente só não daria conta? Ele encheria a própria conversa, ou você já tentou com um e foi lento demais. Sim: vários subagentes, e a próxima é B4. Não: fim do trilho, fique com um subagente só.
- B4. São dezenas de partes ou mais, ou você quer rodar esse mesmo plano de novo? Sim: workflow dinâmico. Rode antes numa fatia pequena, para medir o custo. Não: fim do trilho, os vários subagentes bastam. Comece com poucos e meça os tokens.
Descida.
- D1. A cada troca de modelo: o modelo atual consegue sem esse componente? Sim: remova ou simplifique. Não: mantenha.
O destino é a lista que o seu percurso anotou.
Cinco casos de teste
Os exemplos são de domínio neutro, e em cada caso refaço o percurso inteiro, com a razão de cada resposta. E3 e E4 são sempre não.
- “Colei três vezes o mesmo checklist de revisão de PR, e cada item pede julgamento.” PR é o pedido de revisão de código. E1 sim e E2 não, porque nada pede ajudante. A1 não, porque o checklist é um procedimento e não uma convenção, e A2 não, porque a revisão pede julgamento e só acontece quando alguém a pede. Sem A1 nem A2, o que se repete é uma skill, e A3 não, porque cada item exige julgamento. Destino: skill, só com prosa.
- “Pedi três vezes que o linter rodasse antes de cada commit, e uma vez ele esqueceu.” Linter é a ferramenta que aponta erros de estilo no código. Commit é o registro de uma mudança no Git. E1 sim e E2 não, porque rodar o linter é leve e nada pede ajudante. A1 não, porque rodar o linter é um comando e não uma convenção, e A2 sim, porque o momento é exato, o commit, e a regra não admite exceção. Destino: hook, que chama o comando do linter.
- “Preciso entender uma falha, uma vez só, lendo 200 páginas de log de uma só máquina, e cada evento só faz sentido pelo que veio antes.” E1 não, porque é uma vez só, e E2 sim, porque é saída demais para reler. B0 não, porque entender a causa pede julgamento. B1 sim, porque o trabalho é autocontido e devolve a causa, e B2 não, porque cada trecho depende do anterior e não há partes independentes. Destino: subagente.
- “Quero revisar 500 arquivos de texto, uma vez, e dizer se cada um está claro para quem vai ler, o que exige julgamento.” E1 não e E2 sim, porque as partes são independentes. B0 não, porque dizer se um texto está claro não tem uma saída fixa para cada entrada. B1 sim, porque cada arquivo devolve um veredito, e B2 sim, porque os arquivos só são lidos e não dependem uns dos outros. B3 sim, porque um subagente só não leria 500 arquivos numa conversa, e B4 sim, porque 500 são centenas de partes. Destino: workflow dinâmico, testado antes numa fatia pequena. Se a checagem fosse mecânica, como conferir o cabeçalho de licença, a resposta do B0 seria sim, e o destino, um script.
- “Vou refatorar um módulo cujas partes dependem umas das outras, e vou ajustando o rumo a cada etapa, conversando com o agente.” E1 não e E2 sim, porque a ideia de dividir o trabalho vem à cabeça. B0 não, porque refatorar pede julgamento a cada passo. B1 não, porque o vai e vem acontece com você e as fases compartilham contexto. Destino: conversa principal, sem paralelizar. Se você respondesse sim em B1, o B2 barraria, porque as partes dependem umas das outras.
Cada caso fecha porque o enunciado traz o fato que decide as respostas: o julgamento do checklist, o esquecimento do linter, a dependência entre os eventos do log, o julgamento sobre cada arquivo e o vai e vem da refatoração. Numa tarefa sua, esse fato pode estar escondido, e aí a pergunta serve para você ir atrás dele.
Teste com o seu caso
O guia abaixo traz as mesmas perguntas do fluxo, para responder com sim ou não. Os botões carregam os cinco casos acima, e cada resposta mostra na hora a consequência e o caminho montado até ali.
Quando não subir
Subir custa. Nos dados do sistema de pesquisa multiagente da própria Anthropic, agentes usam cerca de 4 vezes mais tokens que um chat, e sistemas multiagente cerca de 15 vezes. O mesmo texto diz que a maioria das tarefas de código tem menos partes paralelizáveis que uma pesquisa. Leia o 15 como a medida daquele sistema, e meça o seu.
Os recursos do topo são recentes. A página dos workflows dinâmicos avisa quando uma execução passa de 25 agentes ou de 1,5 milhão de tokens projetados, e traz requisitos de versão do Claude Code em vários recursos.
A página dos agent teams os chama de experimentais e desligados por padrão. Para tarefas sequenciais ou com muitas dependências, ela diz que uma sessão só ou subagentes rendem mais. Conferi esses números e rótulos nas páginas originais em 7 de outubro de 2026.
Os padrões de orquestração que as fontes oficiais descrevem são genéricos. Dois deles, de Building effective agents: orchestrator-workers, em que um modelo central quebra a tarefa, delega a outros modelos e reúne os resultados; e parallelization, em que partes independentes rodam ao mesmo tempo.
A menor forma útil
Uso uma regra pessoal para decidir: a menor forma útil. Subir um degrau exige justificar por que o anterior não resolve. Se a fricção não se repetiu o bastante, não criar nada é um resultado válido.
Isso se encadeia com a tese: em qualquer degrau, o passo que dá sempre a mesma saída vira script.
Criando com o writing-skills
O /superpowers:writing-skills é uma skill do plugin superpowers. O prefixo antes dos dois pontos é o nome do plugin. O material é de terceiros: o repositório é o obra/superpowers, a licença é MIT, em nome de Jesse Vincent, e li a versão 6.4.1. O ciclo, a regra de ferro e a lista de quando não criar são dele, em tradução e adaptação minhas.
A ideia central é curta: escrever skill é TDD aplicado à documentação. TDD é escrever o teste antes do código. Aqui, o teste é ver o agente falhar. O ciclo:
- RED. Rode a tarefa com o agente sem a skill e anote o que ele faz de errado, com as palavras dele.
- GREEN. Escreva a skill mínima, só para cobrir essas falhas.
- REFACTOR. Rode de novo, ache as brechas novas, feche e teste outra vez.
A regra de ferro, em tradução livre: nenhuma skill sem um teste falhando primeiro. O texto também define o que é skill: referência de uma técnica reaproveitável, e não a narrativa de um problema que você resolveu uma vez.
E diz quando não criar. A lista abaixo segue a ordem dele:
- solução pontual, de uma vez só;
- prática comum que já está documentada por aí;
- convenção de um projeto específico, que fica no arquivo de instruções do projeto;
- restrição mecânica, que dá para impor com uma validação, como uma regex (expressão regular, um padrão que confere se o texto tem o formato esperado). Automatize, e deixe a documentação para o que exige julgamento.
O último item é a minha tese outra vez, só que escrita por outra pessoa.
O guia oficial da plataforma diz que você não precisa de uma skill de “escrever skills” para o Claude ajudar a criar skills: basta pedir.
Na minha leitura, o que o writing-skills acrescenta é disciplina: só escrever depois de ver a falha. O próprio guia oficial recomenda algo parecido, construir as avaliações primeiro, só que sem usar o nome TDD. Associar os dois é opinião minha.
O método foi pensado principalmente para skills que impõem disciplina sob pressão. O próprio arquivo avisa que proibições podem piorar problemas de formato da saída.
A description é o gatilho
A description é o texto que o Claude usa para decidir quando aplicar a skill. Antes de abrir o corpo, o agente só vê o nome e a descrição. Se ela não casar com o que você pediu, o corpo provavelmente nunca é lido, a menos que você chame a skill pelo nome.
O exemplo “Melhor” é adaptado do Git Commit Helper, da seção Writing effective descriptions da documentação da plataforma. O “Ruim” é meu, no estilo das descrições vagas que essa seção mostra:
# Ruim: vaga, não diz quando usardescription: Ajuda com commits
# Melhor: diz quando usar, com palavras que o usuário diriadescription: Use quando o usuário pedir ajuda para escrever uma mensagem de commit ou para revisar o que está em staging.
Duas dicas de redação, que vêm da documentação: escreva na terceira pessoa (a descrição entra no prompt de sistema) e ponha o caso de uso principal primeiro. No Claude Code, description e when_to_use somados são cortados em 1.536 caracteres na listagem.
E aqui as fontes se dividem: o que a description deve dizer?
- Os docs da plataforma, a especificação do padrão aberto e o guia em PDF pedem o que a skill faz e quando usar. A documentação do Claude Code diz o mesmo na descrição do campo.
- O post do time do Claude Code (junho de 2026) diz, em tradução livre, que a descrição é uma descrição de quando disparar a skill, e não um resumo.
- O
writing-skillsvai além: só quando usar, nunca o que a skill faz. A justificativa dele vem de um teste próprio: uma descrição que resumia o fluxo fez o agente seguir o resumo e pular o corpo.
Não achei evidência oficial para esse teste do terceiro item, e não o verifiquei por conta própria. Os exemplos bons do guia da plataforma, por sinal, trazem uma frase de gatilho (“Use when…”).
Eu começo pelo gatilho, com as palavras que o usuário diria, e deixo os passos do procedimento para o corpo. A escolha é minha: nenhuma fonte a impõe.
Contraexemplo: a description da melhoria-continua
Para sair da teoria, trago uma description minha que eu escreveria diferente hoje. É a da skill melhoria-continua, como está instalada. No arquivo ela é uma linha só; quebrei a linha aqui para caber na tela, sem mudar nenhum caractere:
description: >- Use quando o Iago pede para olhar as próprias repetições entre sessões — "verifica as repetições", "o que eu repito", "o que dá para virar script", "melhoria contínua" — ou quer saber que código o agente reescreve inline no Bash em vez de chamar uma ferramenta. Roda o `recorrencia` (index, report --estrutural, doctor), que conta e agrupa por script a partir dos transcripts do Claude Code, redigindo segredo e PII antes de gravar; o modelo só lê o relatório. Na fatia F1 mostra só repetição de MESMA FORMA e não propõe ferramenta.Contei hoje, por script: 532 caracteres. Está bem abaixo do limite de 1.024 e do corte de 1.536 do Claude Code. O writing-skills pede menos de 500, se possível, e a minha passa um pouco. O que me incomoda é o conteúdo.
O que eu mudaria:
- A primeira frase está boa. “Use quando…”, com frases que eu de fato digo.
- A segunda metade resume o que o motor faz. É exatamente o que o
writing-skillsdesaconselha. Pelo critério dos docs oficiais, “o que faz” é esperado, mas esse nível de detalhe eu deixaria para o corpo da skill. - A última frase carrega estado. “Na fatia F1…” fica errada no dia em que a próxima fatia sair. O guia da plataforma pede para evitar informação que envelhece.
Um rascunho do que eu escreveria hoje. É hipotético, não foi testado e existe só neste texto:
description: >- Use quando o usuário pedir para olhar as próprias repetições entre sessões ("verifica as repetições", "o que eu repito", "o que dá para virar script", "melhoria contínua") ou quiser saber que código o agente reescreve inline no Bash em vez de chamar uma ferramenta.A skill instalada continua com a descrição original. Não mexi nela para escrever este artigo.
Dicas para a primeira skill
- Comece de uma tarefa real, como já falei acima.
- Não ensine o que o modelo já sabe. O guia do padrão aberto manda perguntar a cada trecho: o agente erraria isso sem essa instrução? Se não, corte.
- Tenha uma seção de gotchas e alimente com os erros do agente. Gotcha é um fato do seu ambiente que contraria o que o modelo assumiria. O guia do padrão aberto recomenda deixar a seção no próprio
SKILL.md, para o agente ler antes de esbarrar no problema. E o time do Claude Code conta que as melhores skills deles começaram como poucas linhas e um único gotcha. - Dê liberdade onde há variação e trilho onde é frágil. No guia da plataforma, o exemplo de trilho é mandar rodar exatamente um comando, sem mudar as flags.
- Diga quando abrir cada arquivo. No guia do padrão aberto,
Leia references/erros-da-api.md se a API devolver status diferente de 200(exemplo adaptado) funciona melhor do queveja a pasta references. Mantenha só um nível de profundidade, como pede o guia da plataforma. - Escolha um padrão e uma saída de emergência. Em vez de listar quatro bibliotecas, indique uma e diga o que fazer no caso especial. O guia do padrão aberto chama isso de dar um padrão em vez de um cardápio.
- Uma skill, uma unidade coerente de trabalho. Estreita demais obriga a carregar várias de uma vez. Ampla demais fica difícil de disparar com precisão, segundo o guia do padrão aberto. A checklist para empresas acrescenta que uma descrição larga pode roubar o gatilho de skills que já existem.
- Nome em minúsculas, com hífen, igual ao da pasta, até 64 caracteres, de preferência com verbo ou gerúndio (
processing-pdfs). Vem da especificação e do guia da plataforma, que reserva as palavras “anthropic” e “claude” noname. Observação minha, ao ler owriting-skills: o modelo de frontmatter dele usaSkill-Name-With-Hyphens, com maiúsculas, o que viola a especificação. Fique com a regra da especificação. - Corpo com menos de 500 linhas, como recomenda a documentação do Claude Code. O que passar disso vai para arquivos separados.
- Revise de tempos em tempos. A Anthropic separa dois tipos de skill. A que dá ao modelo uma capacidade que ele não tinha pode perder a razão de existir quando o modelo melhora. A que registra a sua preferência de fluxo tende a durar mais.
Duas armadilhas dão trabalho justamente por serem silenciosas (descritas na documentação do Claude Code):
- se o YAML do cabeçalho estiver quebrado, a skill carrega sem metadados e o agente não consegue casar a descrição;
- campo escrito errado é ignorado, sem aviso. A abertura
---precisa ser a primeira linha do arquivo.
E um limite que pega quem junta muitas skills: o catálogo tem orçamento de cerca de 1% da janela de contexto. Quando estoura, o Claude Code corta primeiro as descrições das skills menos usadas.
Como testar
Duas camadas, e as duas cabem num dia.
Gatilho: a skill carrega quando deveria? O guia do padrão aberto sugere uns 20 prompts realistas. Metade deve disparar, metade deve ficar quieta, e os melhores negativos são quase-erros, que dividem palavras com a sua skill. Rode cada um umas 3 vezes, porque o modelo varia.
Para começar menor, 3 a 5 prompts já dizem alguma coisa.
Qualidade: a skill melhora o resultado? Rode a mesma tarefa com e sem a skill, numa sessão limpa. Sessão limpa importa: o contexto que sobrou de quando você escreveu a skill esconde as lacunas dela. O guia de avaliação do padrão aberto sugere começar com 2 ou 3 casos.
Uma dica de diagnóstico do guia da Anthropic em PDF (p. 25, na parte sobre skill que não dispara): pergunte ao Claude “quando você usaria a skill X?”, em tradução livre. Ele cita a descrição de volta, e você ajusta o que faltar.
Escrevo em 7 de outubro de 2026, e a data importa: as práticas de teste mudaram rápido este ano.
O guia oficial em PDF, de janeiro, dizia que o skill-creator (plugin oficial da Anthropic para criar skills) não executa testes automatizados. Em março, a Anthropic anunciou melhorias nele: evals (casos de teste com resultado esperado) e benchmark (comparação com e sem a skill). Se você lê isto bem depois, confira a data.
Cuidado com skill de terceiros
A regra oficial é direta: use skills apenas de fontes confiáveis, as que você criou ou as que vêm da Anthropic. Uma skill pode mandar o agente executar código de formas que não batem com o propósito declarado.
Instalar skill alheia é como instalar software. Leia todos os arquivos, principalmente os scripts, e desconfie de chamadas de rede e de credenciais escritas no texto.
Um dado de contexto. A Snyk, empresa de segurança, escaneou 3.984 skills de registros comunitários em 5 de fevereiro de 2026. Segundo ela, 13,4% tinham ao menos um problema de nível crítico. A fonte é comercial, e o levantamento cobre registros da comunidade, sem incluir skills da Anthropic. Leia como um alerta.
O caso da melhoria-continua
Esta é a skill que uso como exemplo, porque ela mesma é um caso de repetição virando ferramenta. O problema que ela ataca, segundo o próprio SKILL.md: o agente reescreve o mesmo procedimento várias vezes, em Python ou shell inline, em vez de chamar um script.
O repositório onde ela mora é privado, então não há link. O que segue vem do SKILL.md.
O que existe
Segundo o SKILL.md, a fatia F1 está pronta. Ela tem três comandos do motor recorrencia:
index: lê os transcripts locais do Claude Code (o registro de cada conversa), separa os blocos de código de cada comando, redige segredo e dados pessoais antes de gravar, normaliza e guarda num índice local, derivado e reconstruível.report --estrutural: agrupa os blocos que têm a mesma forma.doctor: diz o que falta no ambiente.
Ainda segundo o SKILL.md, na F1 o motor roda sem nenhum LLM e nada sai da máquina.
A regra central da skill é a minha tese em prática: o modelo não procura repetição, contar é do script. O modelo roda os comandos, lê o relatório e conversa comigo citando os números.
O relatório começa com um aviso: “mesma forma não prova mesma finalidade”. Um SELECT e um DELETE têm a mesma forma e fazem coisas diferentes. A F1 não sabe separar isso.
Os números que contei hoje: a descrição tem 532 caracteres. O arquivo tem 231 linhas, e o corpo, sem o cabeçalho, tem 227 (o limite de 500 vale para o corpo). Há também um arquivo de evals com 6 casos, o que não prova, sozinho, que um baseline foi rodado antes.
O que é só plano
Segundo o SKILL.md, a F2 e a F3 ainda não existem. São intenção:
- F2: comparar repetição por finalidade entre sessões, além da forma. Registrar decisões sobre cada grupo. Medir se uma ferramenta nova está sendo usada.
- F3: levar um caso real, da detecção até uma ferramenta em uso.
Uma boa prática que vale copiar: a skill tem uma seção dizendo ao agente o que ainda não existe. Se eu pedir um comando da F2, ela manda o agente responder que não há, em vez de improvisar. Um agente prestativo demais tende a inventar subcomando, e escrever o limite na skill é a minha aposta contra isso.
Como começar hoje
Cabe numa tarde. Os passos valem para o Claude Code. Outros produtos adotaram o mesmo formato, e o quickstart do agentskills.io diz que a mesma skill funciona em agentes compatíveis, mas a pasta muda: o VS Code, por exemplo, procura em .agents/skills/.
- Escolha algo que você já repetiu no chat, de preferência três vezes.
- Crie a pasta, com o nome da skill. No exemplo abaixo ela se chama
resumindo-mudancas. Para uso pessoal, em todos os seus projetos, fica em~/.claude/skills/resumindo-mudancas/. Para o time do repositório, fica em.claude/skills/resumindo-mudancas/, e quem clonar recebe a skill depois que você commitar. Se outras pessoas precisarem dela em outros repositórios, aí entra o plugin, como na pergunta E4. O nome da pasta deve ser igual aonamedo arquivo. - Escreva o
SKILL.md. Este exemplo é traduzido e adaptado dosummarize-changes, da documentação do Claude Code. O original não temname, abre adescriptioncom um resumo do que a skill faz e usa a linha!`git diff HEAD`para injetar o diff antes de o Claude ler. Aqui mantive as instruções, em tradução, e removi a injeção do diff. O cabeçalho segue o padrão aberto, comnamee umadescriptionsó com o gatilho:
---name: resumindo-mudancasdescription: Use quando o usuário perguntar o que mudou, pedir mensagem de commit ou revisão do diff local.---
Resuma as mudanças não commitadas em 2 ou 3 bullets.Liste riscos: falta de tratamento de erro, valores fixos no código, testes a atualizar.Se não houver diff, diga que não há mudanças.- Confira se carregou. Rode
/skillsou pergunte ao agente quais skills ele tem. A edição é pega na hora, sem reiniciar a sessão (se a pasta~/.claude/skillsnão existia quando a sessão começou, rode/reload-skills). - Teste os dois jeitos de disparo. Numa pasta com mudanças ainda não commitadas, pergunte algo que case com a descrição, como “o que eu mudei?” (a documentação usa “What did I change?” de exemplo). Depois chame
/resumindo-mudancasno começo da mensagem. - Quando o agente errar, registre a correção na seção de gotchas. E se ele reescrever a mesma lógica a cada vez, é o sinal para virar script.
Se quiser o método completo, rode o /superpowers:writing-skills e siga o ciclo RED, GREEN, REFACTOR.
Por fim
Uma skill é um procedimento repetido que você escreveu uma vez para não explicar de novo. Quando a saída dele é sempre a mesma, vale mais um script do que um parágrafo. Quando depende de julgamento, a prosa basta. E quando a regra não pode falhar nunca, o lugar dela é um hook. Subir da skill para subagentes e workflows pede outro motivo: contexto, ferramentas ou paralelismo.
Fica um ponto que ainda não está resolvido para mim, e as fontes também não resolvem: o que a description deve dizer. Escolhi começar pelo gatilho. Pode ser que daqui a uns meses eu mude de ideia.
Espero que este artigo tenha sido útil. E você, qual procedimento colou no chat pela terceira vez esta semana?
Referências
- Claude Code, Extend Claude with skills
- Claude Code, Extend Claude Code
- Claude Code, Automate actions with hooks
- Plataforma Claude, Agent Skills
- Plataforma Claude, Skill authoring best practices
- Plataforma Claude, Skills for enterprise
- Anthropic Engineering, Equipping agents for the real world with Agent Skills (16/10/2025)
- agentskills.io, Agent Skills Overview
- agentskills.io, Specification
- agentskills.io, Best practices for skill creators
- agentskills.io, Quickstart
- agentskills.io, Optimizing skill descriptions
- agentskills.io, Evaluating skill output quality
- Anthropic, The Complete Guide to Building Skills for Claude (PDF, janeiro de 2026)
- Claude, Improving skill-creator: test, measure, and refine agent skills (03/03/2026)
- Thariq Shihipar, Lessons from building Claude Code: How we use skills (03/06/2026)
- Snyk, ToxicSkills: Malicious AI agent skills on ClawHub (05/02/2026)
- Claude Code, Create custom subagents
- Claude Code, Orchestrate subagents at scale with dynamic workflows
- Claude Code, Orchestrate teams of Claude Code sessions (recurso experimental)
- Claude Code, Run agents in parallel
- Claude Agent SDK, Subagents in the SDK
- Anthropic Engineering, Building effective agents (19/12/2024)
- Anthropic Engineering, How we built our multi-agent research system (13/06/2025)
- Anthropic Engineering, Harness design for long-running application development (24/03/2026)
- Repositório
obra/superpowers(licença MIT, copyright de Jesse Vincent), skillwriting-skills(versão 6.4.1, material de terceiros) - agentskills.io, Using scripts in skills
- Claude Code, How Claude remembers your project
- Claude Code, Settings files and precedence
- Claude Code, Plugins overview
Continue lendo
Gotcha Lembrado é Gotcha Esquecido
A regra de virar script todo passo determinístico virou hábito. Quatro sinais de alerta, dois exemplos reais e quanto isso pesa em token, de verdade.
Determinismo vira script: o teste que uso para saber quando parar de pedir para a IA
Se duas execuções corretas dão a mesma saída, é script, não trabalho para a IA. O teste que uso, três exemplos práticos e o que isso economiza em token.
Quatro meses com o ai-memory: o que muda quando o agente lembra da sessão anterior
Quatro meses e 3.359 sessões com o ai-memory: histórico entre agentes, consolidação, auto-improve e o que isso me ensinou sobre o que vira script.