Quatro meses com o ai-memory: o que muda quando o agente lembra da sessão anterior
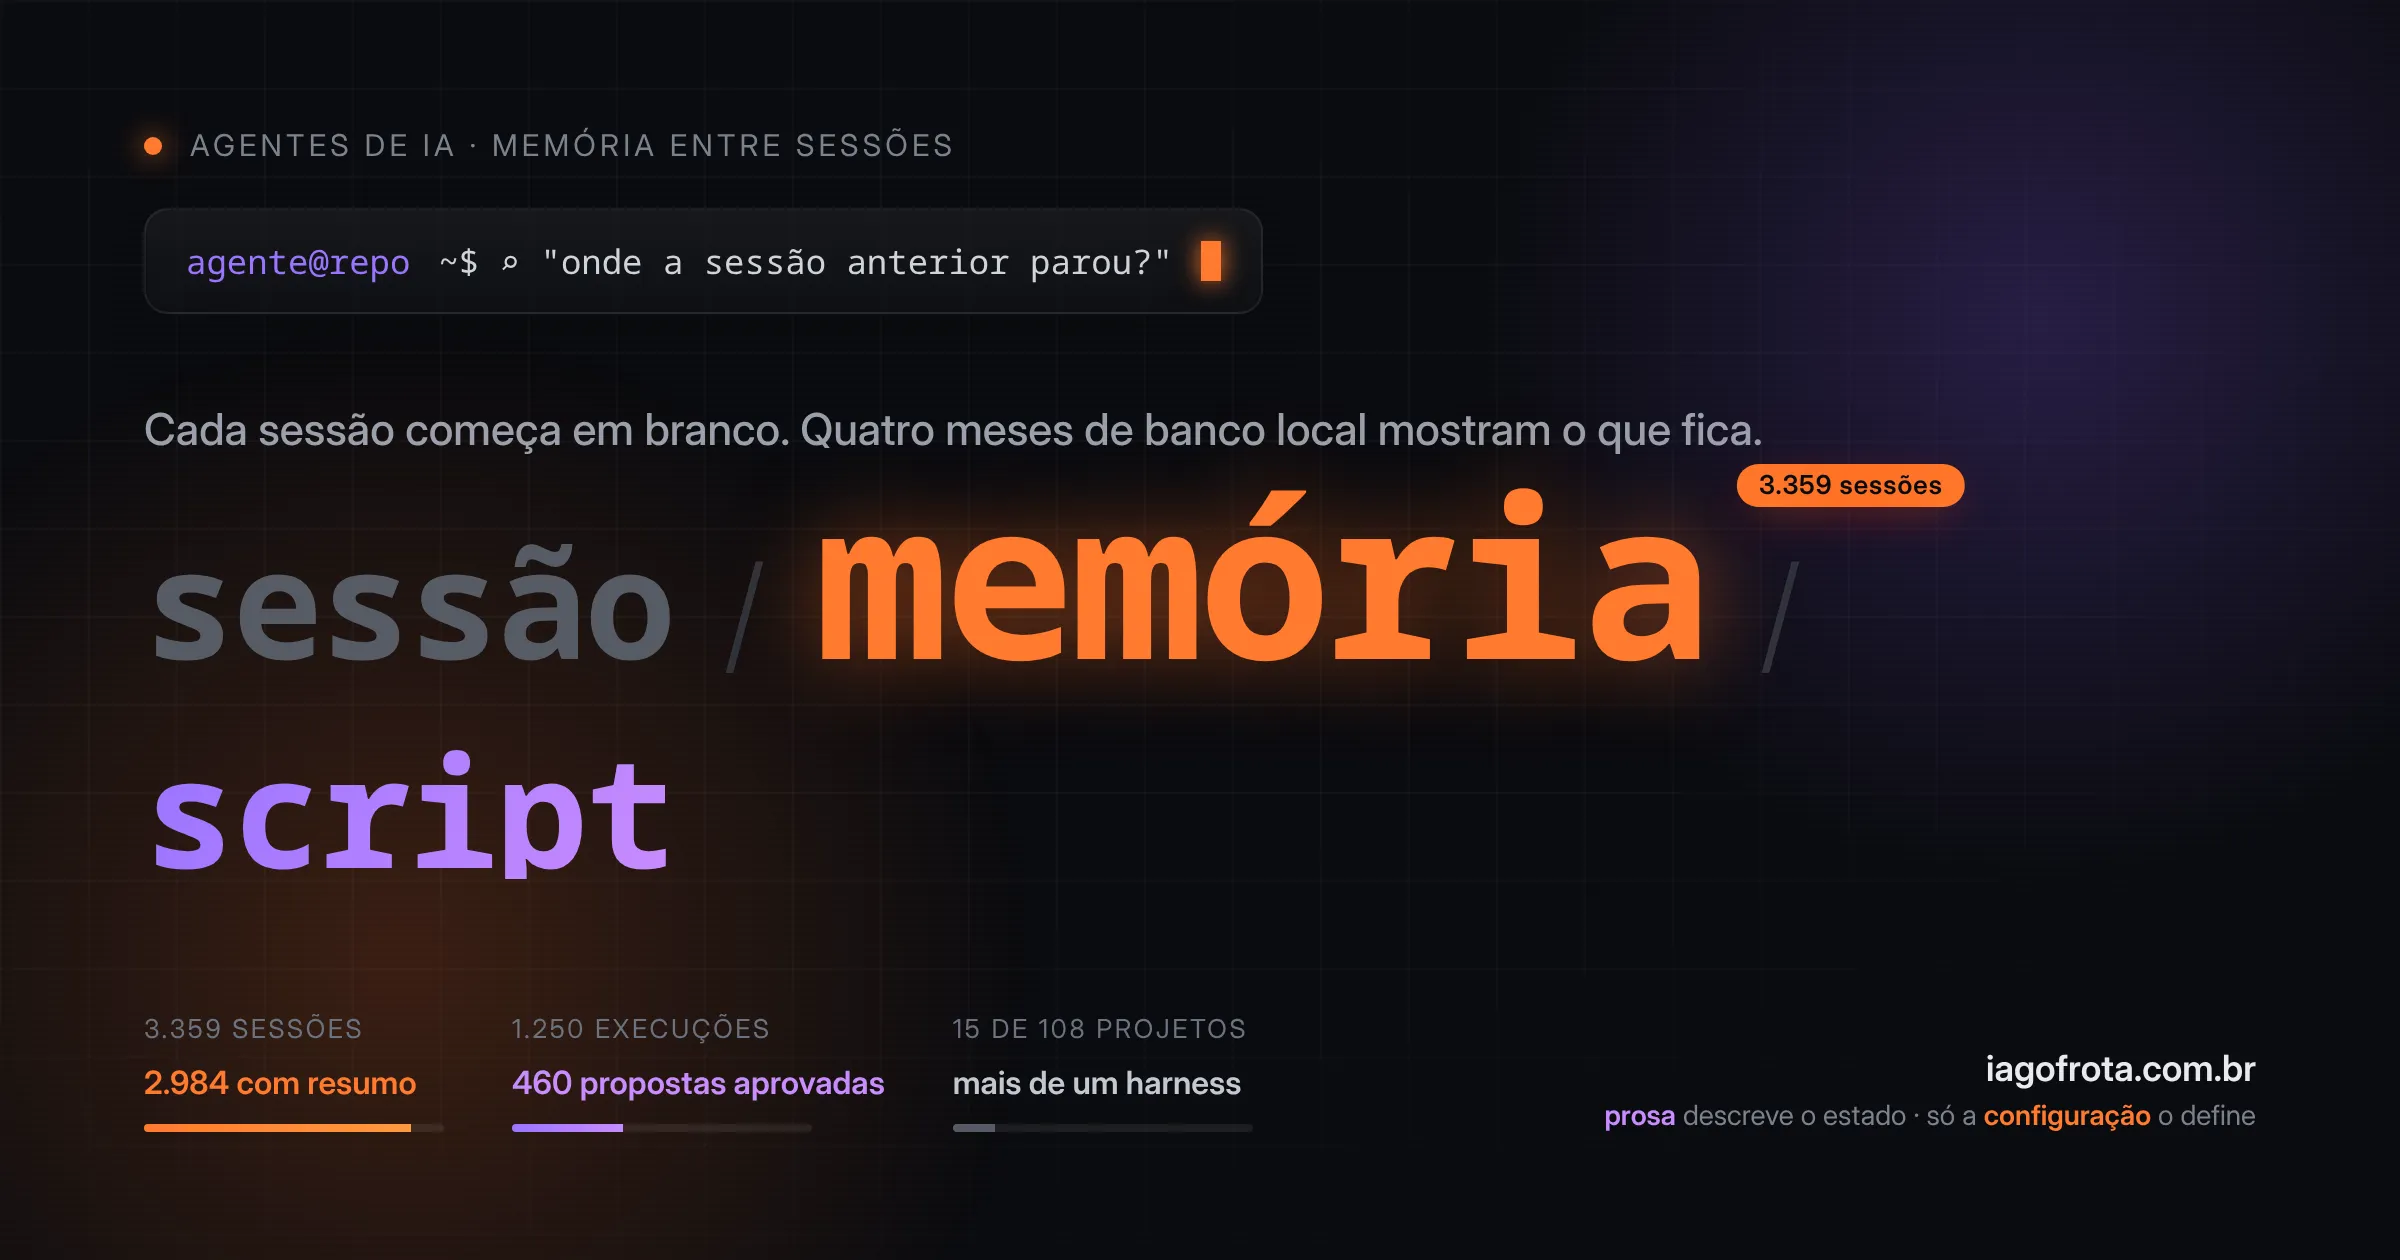
Quatro meses e 3.359 sessões com o ai-memory: histórico entre agentes, consolidação, auto-improve e o que isso me ensinou sobre o que vira script.
Agente de código tem um problema de desenho: cada sessão começa em branco. Quando ela acaba, some a arquitetura que você explicou, somem as abordagens que já falharam e some a pergunta que ficou em aberto.
Em 25 de maio de 2026 comecei a usar o ai-memory para atacar isso. Este texto junta o que quatro meses de uso deixaram registrado no banco local.
Sobre o ai-memory
O ai-memory é um projeto do Fabio Akita, escrito em Rust, com licença MIT. A ideia do README é direta: sair do Claude Code no meio da tarefa, abrir o Codex no mesmo diretório e continuar sem reexplicar nada.
O caminho é este. Hooks de ciclo de vida capturam observações sanitizadas durante a sessão. No fim, elas viram um resumo coerente. O próximo agente recebe isso como handoff.
A memória é uma wiki em markdown dentro de um repositório git, exposta aos agentes via MCP. Dá para dar grep nela, e dá para abrir no Obsidian.
Uso a versão 2.4.2, num container Docker. O passo a passo de instalação está no repositório.
Quatro meses de uso
O store foi criado em 25/05/2026, às 16h11 (UTC), e a primeira sessão foi capturada quatro minutos depois. Essa é a data de adoção.
Os números deste texto são de 30/09/2026, por volta de 16h44 (horário de Fortaleza). O banco segue crescendo, então o que você vê hoje já é um pouco maior. Naquele momento, o banco local tinha 3.359 sessões e 437.757 observações. A evolução por mês:
- maio (a partir do dia 25): 173 sessões
- junho: 271
- julho: 574
- agosto: 525
- setembro: 1.816
Setembro teve cerca de 3,5 vezes as sessões de agosto.
São 108 projetos cadastrados e 3.490 handoffs registrados: 2.820 aceitos, 373 expirados e 297 ainda abertos.
Histórico entre provedores
A promessa do projeto é trocar de ferramenta sem perder contexto. Dos 3.359 registros, 3.190 são do Claude Code. O resto é Codex (83), OpenCode (53), Antigravity CLI (30) e Cursor (3).
O volume de cada um diz pouco sobre a troca de ferramenta. Dos 108 projetos, 15 tiveram sessões de mais de um harness.
Esses 15 são o caso que a promessa descreve: o mesmo projeto, com agentes diferentes, sobre a mesma memória. Quinze é pouco para tirar conclusão estatística.
Os números também não dizem quanto contexto um agente aproveitou do outro. Não consegui medir isso, e por isso não vou chutar.
Consolidação de sessões
Consolidação é o momento em que a sessão vira resumo. Das 3.359 sessões, 2.984 têm resumo consolidado.
Os jobs de consolidação somam 1.535 concluídos e 419 falhas. Essas 419 falhas vêm de 413 sessões, e todas elas têm resumo hoje.
A wiki que sai disso tem 3.995 páginas atuais, ou 12.651 contando as versões. A wiki em markdown e git ocupa cerca de 842 MiB. O banco SQLite do ai-memory é maior: 1,6 GiB naquele momento.
Auto-improve
Esta é a parte que estou estudando, e não a que considero resolvida.
Consolidação e auto-improve são coisas diferentes. A primeira resume a sessão. O auto-improve roda depois, em background, desde 24/06/2026, e propõe conhecimento durável: edições pequenas na wiki em gotchas/, decisions/, procedures/, _rules/ e concepts/.
Ele não olha tudo. Na minha configuração, a sessão precisa ter pelo menos 8 observações e 120 segundos. A entrada tem um orçamento de 24.000 tokens. Cada execução propõe até 5 edições, com confiança mínima de 0,75, e as propostas são aprovadas automaticamente. Esses valores são meus, não um padrão universal. Tudo fica numa trilha de auditoria, e dá para exigir aprovação manual.
Foram 1.250 execuções. Só 632 chamaram um LLM (OpenAI via OAuth e Anthropic). As outras execuções não chamaram modelo.
O resultado: 460 propostas aprovadas.
- gotcha: 236
- rule: 87
- decision: 58
- procedure: 30
- concept: 28
- note: 21
E 2.325 registros de rejeição ou filtragem, além de 478 registros de amostragem. Os motivos mais frequentes da rejeição ou filtragem:
too_few_observations: 348session_too_short: 271one_off_task_narrative: 83already_materialized_in_session: 66insufficient_evidence: 59duplicate_existing_knowledge: 58generic_agent_tool_guidance: 45
Os 478 registros de amostragem (input_budget_sampled) não são rejeição. São o aviso de amostragem, do tipo “selecionei 48 de 156 observações”, e 231 das execuções com esse registro geraram propostas. Sessão grande não cabe inteira no orçamento.
Um exemplo daqui deste blog. Em 60 dias, o auto-improve rodou 12 vezes neste projeto e aprovou 7 propostas. Uma é a procedure “validar elegibilidade de publicação de post estático”, criada e atualizada duas vezes. Outra é o gotcha “cobertura isolada não substitui o gate do projeto”.
Quando a lição vira script
Aqui o ai-memory encontra uma premissa que já defendo: o que é determinístico vira script, não inferência do modelo. Se duas execuções corretas do mesmo passo dão a mesma saída, é script.
O auto-improve produz um sinal útil para isso. Quando a mesma procedure reaparece sessão após sessão, é um passo determinístico sendo reinferido pelo modelo. A lição repetida é o cheiro.
Mantenho um backlog de determinismo e registros de fluxo, contados pela skill melhoria-continua, no repositório skills-portaveis. A divisão de donos é simples: lição de sessão é do auto-improve, código repetido entre sessões é da contagem de recorrência, e sequência de passos repetida é do registro de fluxo. Assim a mesma lição não fica escrita em três lugares.
Nem toda fricção vira skill. Uso uma escada de menor intervenção: anotação, regra, skill, comando, agente. Não criar nada também é resultado válido.
O comentário que mentia
No config.toml do ai-memory deixei um comentário dizendo que o scheduler do auto-improve rodaria a cada 86400 segundos, que é o intervalo da minha configuração. O padrão era a cada hora (3600 segundos), e numa madrugada, entre 21h30 de 5 de agosto e 5h31 de 6 de agosto (horário de Fortaleza), 9 chamadas falharam com erro 429.
Em 1º de setembro, auditando o arquivo antes de atualizar a versão, vi que o valor nunca tinha sido alterado. Segundo o próprio comentário, o valor deveria ser 86400, mas ficou quase um mês em 3600.
A prosa descrevia o estado. Só a configuração o definia.
Um detalhe para não confundir: 86400 segundos não significa uma chamada por dia. A cada rodada o scheduler percorre os projetos, com até uma sessão por projeto.
Conclusão
Depois de quatro meses, tenho números e perguntas.
Não sei se os 460 itens aprovados valem a pena na média. Não tenho medida de quanto os handoffs poupam de reexplicação. Das 1.250 execuções do auto-improve, 632 usaram modelo.
Há também um risco sem resposta: memória gerada por agente pode guardar uma conclusão errada com o mesmo ar de certeza de uma certa.
Por fim, a pergunta que o ai-memory me deixa é esta: o que, nas minhas sessões, já é script e ainda está sendo pedido ao modelo?
Espero que este relato ajude quem está pensando em dar memória aos seus agentes. E você, o que o seu agente esquece todo dia?
Continue lendo
Gotcha Lembrado é Gotcha Esquecido
A regra de virar script todo passo determinístico virou hábito. Quatro sinais de alerta, dois exemplos reais e quanto isso pesa em token, de verdade.
Determinismo vira script: o teste que uso para saber quando parar de pedir para a IA
Se duas execuções corretas dão a mesma saída, é script, não trabalho para a IA. O teste que uso, três exemplos práticos e o que isso economiza em token.
Nem sempre precisa do modelo maior: um mês de Luna no modo Auto do Copilot
Deixei o Copilot escolher o modelo sozinho e o Luna, um modelo leve, deu conta de muita coisa. Fui aos logs ver o que os dados confirmam e o que não.